【Reference】: https://zhuanlan.zhihu.com/p/349594815
渲染中的加速结构大致可以分为两类,一种是基于物体的加速结构,一种是基于空间的加速结构,本质上都是为了避免每条光线、每块像素、每个物体都与整个场景进行暴力测试。
一:基于物体的加速结构#
传统的包围球 / 包围盒结构#
多用于视锥剔除与碰撞检测,而在实际渲染中并不常用,因为球体或任意朝向盒的求交运算远比 AABB 复杂。
层次包围盒(BVH, Bounding Volume Hierarchy)#
最常用的加速结构,本质上是一棵基于物体的划分树(一般是二叉树,但也可以是四叉、八叉等)。
假设现在需要对场景中的所有三角形进行求交,最暴力的方法是逐个进行测试,时间复杂度是 $O(n)$;如果使用 BVH 进行测试,平均情况下可以降低到接近 $O(\log n)$。
在构建时,首先计算整个场景的包围盒(通常是 AABB,轴对齐包围盒),然后将物体(三角形等)分成两组,分别计算它们的包围盒作为子节点 / 左右子树,以此类推,直到叶子节点包含极少数的三角形。
BVH 的结构#
- 根节点:一个囊括了整个场景的巨大包围盒。
- 中间节点:仍然是一个包围盒,但是相对于父节点来说,细分层级更高(包围盒更小),盒内包含的面片数量更少,同时还包含两个指向子节点的指针。
- 叶子节点:一个包围盒,以及指向实际几何数据的指针 / 索引(比如两个三角形)。
BVH 的遍历流程#
- 从栈顶取出一个 AABB 与光线进行求交。
- 如果没有相交:直接
continue跳过,进入下一轮循环。 - 如果存在交点:返回进入该 AABB 的最短距离 $t_{enter}$。
- 如果没有相交:直接
- 将 $t_{enter}$ 与之前记录的 $t_{max}$ 进行比较,进行剪枝。
- 如果 $t_{max} \le t_{enter}$,就说明当前这个 AABB 被挡住了,光线不应该看到它,因此直接舍弃。
- 反之,则进入这个 AABB。
- 进入 AABB 后,还需要根据节点类型进行不同的处理。
- 叶子节点:直接对里面包含的所有三角形执行求交,并根据返回的距离判断是否更新 $t_{max}$。
- 中间节点:光线分别与左右两个 AABB 求交,并得到与两个盒子的距离,将距离较远的盒子压入栈底,距离较近的盒子压入栈顶。
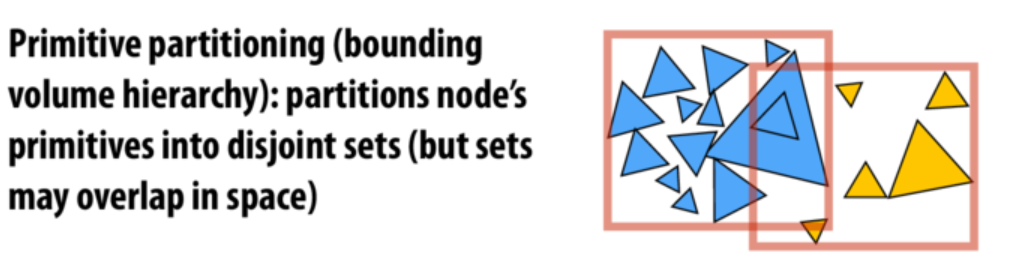
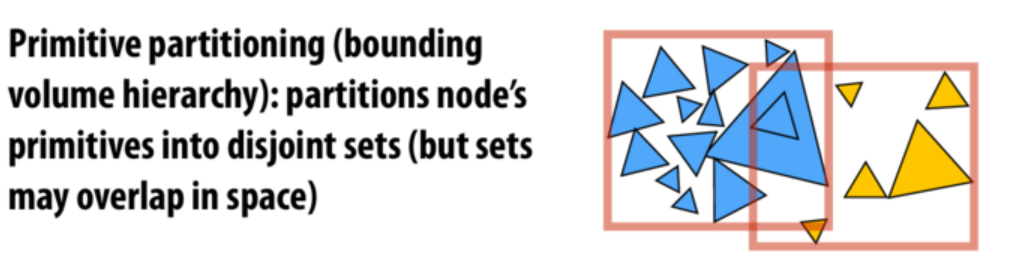
缺点:多个包围盒可能出现重叠的情况(如图),此时单单只对一个包围盒执行求交操作是不够的,因为并不清楚哪个包围盒在前,所以需要对左右两棵子树都执行求交,这样才可以确定下一步要进入哪个包围盒。
二:基于空间的加速结构#
KD-Tree(K-Dimensional Tree)#
KD-Tree 的核心思想是:不断地用一个轴平面对空间进行分割,逐步将场景划分为更小的区域;光线只需要检查它所经过的区域内的物体,而不是所有三角形。
KD-Tree 的结构#
- 根节点:整个场景的包围盒。
- 中间节点:记录当前节点的划分轴与划分位置。
- 叶子节点:代表当前 kd-tree 的最小层级区域,包含此区域内所有三角形数据的指针。
如果一个物体同时处于多个区域,那么每个区域对应的叶子节点中都会存在这个物体的指针。
KD-Tree 的遍历流程#
- 光线首先与根节点相交,计算与划分平面的交点的距离。
- case 1:光线只击中近端的空间,只递归遍历近端子树。
- case 2:光线只击中远端的空间,只递归遍历远端子树。
- case 3:光线先穿过近端,再穿过远端,先将远端子树压入栈中,接着递归遍历近端子树。
优点:相较于 BVH,KD-Tree 的计算量更小,因为 KD-Tree 的遍历遵循“由近及远”原则,所以光线一旦与三角形相交,且光源与交点的距离小于与远端的距离,就可以确定这就是最近交点;而 BVH 由于可能存在重叠的情况,即使在左子树中找到了交点,也无法确定这就是最近交点,仍然需要将右子树也遍历一遍。
缺点:内存开销不可控;构建速度极慢(无法实现动态重建);硬件访问不友好。
八叉树(Octree)#
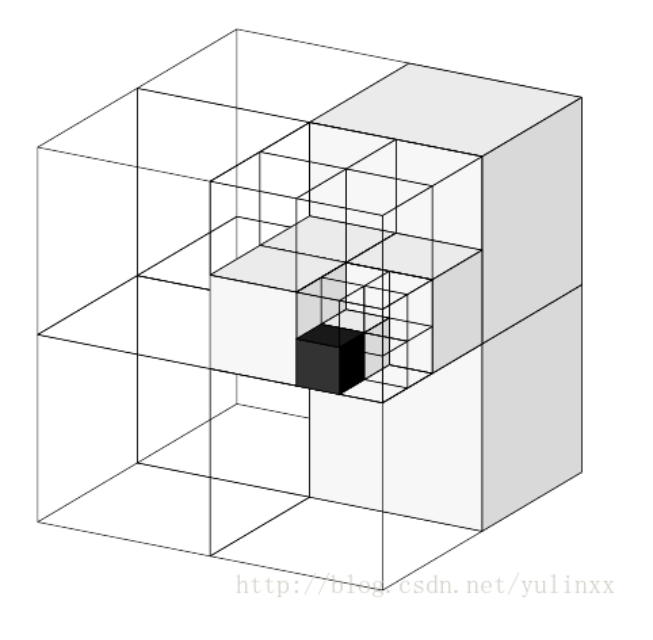
核心逻辑:在三维空间中,每一次切分都需要沿着 x 轴、y 轴、z 轴各切一刀,将其均分为八块。
Octree 的结构#
- 根节点:一个包裹着整个场景的严格立方体。
- 中间节点:含有 8 个指向子节点的指针。
- 叶子节点:不可再分的最小立方体单元,它可以包含其中所有的三角形数据的指针,也可以作为体素直接参与体素渲染。
八叉树一般不用于光线与物体求交的加速,因为它的划分实在是太过规整了,面对复杂 / 动态的几何体时会非常吃力(比如可能出现所有三角形全部堆积在一个小立方体内的情况);但是在全局光照(如 SVOGI 等)、视锥剔除领域,八叉树应用得非常广泛。
均匀网格(Uniform Grid)#
核心思想:抛弃树形结构,直接将场景均分为若干个完全相同的格子。
Uniform Grid 底层的数据结构非常简单,只有两个数组:
- 网格标头数组:一个一维数组,长度严格等于 $N_x \times N_y \times N_z$(即三维分辨率的乘积)。每个元素非常简单,只存一个整数,指向“物体列表数组”的起始索引。
- 物体列表数组:一个连续的内存块,按顺序存放每个格子里包含的三角形(或粒子)的 ID。
因此对于场景中的每一个点,如果想要知道自身处于哪一个格子,都可以在 $O(1)$ 的时间复杂度内对其进行查询;之后进行光线求交时,Uniform Grid 会采用 3D DDA 算法像走棋盘一样沿着光线方向逐个推进格子,每进入一个格子,光线就会与该格子里记录的三角形进行求交测试。
由于网格是严格由近及远推进的,一旦在当前格子内找到了交点,算法就可以立刻提前终止并返回结果,从而直接跳过后面所有剩余的格子。
既然构建简单(平铺直叙)、定位 $O(1)$、遍历无栈,为什么现代光线追踪不用它?
图形学中有一个著名的黑话叫 “茶壶与体育场(Teapot in a stadium)”问题。它精确地命中了均匀网格的死穴:
假设你的游戏场景是一个巨大的足球场(空旷空间),而在球场正中心放了一个做工极其精细的茶壶(包含 100 万个微小三角形)。
如果你要用均匀网格来加速这个场景,你会陷入两难的绝境:
如果格子定得太大(网格太稀疏):整个球场可能就被分成了 4 x 4 x 4 个格子。那么中心的那个格子会把整个茶壶的 100 万个三角形一股脑全部吞进去。当光线射中这个中心格子时,退化成暴力求交,网格形同虚设。
如果格子定得太小(网格太精密):为了把茶壶表面的三角形分干净,你把格子大小设为 1 毫米。这意味着周围空旷的足球场空间也被切成了几百亿个 1 毫米的空格子。
内存崩塌:海量的空格子会瞬间吃光所有的显存。
遍历雪崩:一束光线从球场的一端射向另一端,它不得不无意义地执行几万次 DDA 循环去“走格子”(哪怕里面全是空气),渲染速度直接跌入谷底。
因此,Uniform Grid 通常只用于物理仿真、流体模拟、粒子碰撞等方面。
附:现代实时光线追踪中的加速结构#
在 DirectX Raytracing、Vulkan RT 等 API 中,为了在 GPU 上实现每秒数百万甚至更多次的光线求交,使用的都是 BLAS + TLAS 的两层 BVH 架构。
1. BLAS(Bottom-Level Acceleration Structure,底层加速结构)#
BLAS 针对的是每一个独立模型内部的三角形,与上文所说的 BVH 基本相同;相较于 TLAS,BLAS 的构建成本更高,通常会采用 SAH 算法,其内部存储的是真实的顶点与三角形数据。
2. TLAS(Top-Level Acceleration Structure,顶层加速结构)#
TLAS 内部不包含任何三角形,只有不同的 BLAS 实例,以及每个实例各自在世界空间中的变换矩阵、材质 ID、遮罩等;由于 TLAS 的大小仅仅只和场景中的物体个数相关(通常几千到几万个),数据量较小,所以 TLAS 的构建速度远快于 BLAS,也就可以在每帧进行重建。
保存 BLAS 的世界矩阵的原因
正因为 BLAS 的构建速度较慢,因此难以实现每帧进行重建,所以采用“空间换时间”的策略,即将每个实例的世界矩阵保存下来。之后当画面运动时,只需要通过前一帧的世界矩阵反推出模型空间坐标,再使用当前帧的世界矩阵即可实现在不重建 BLAS 情况下的空间变换。