一:游戏渲染中的挑战#
二:了解 GPU#
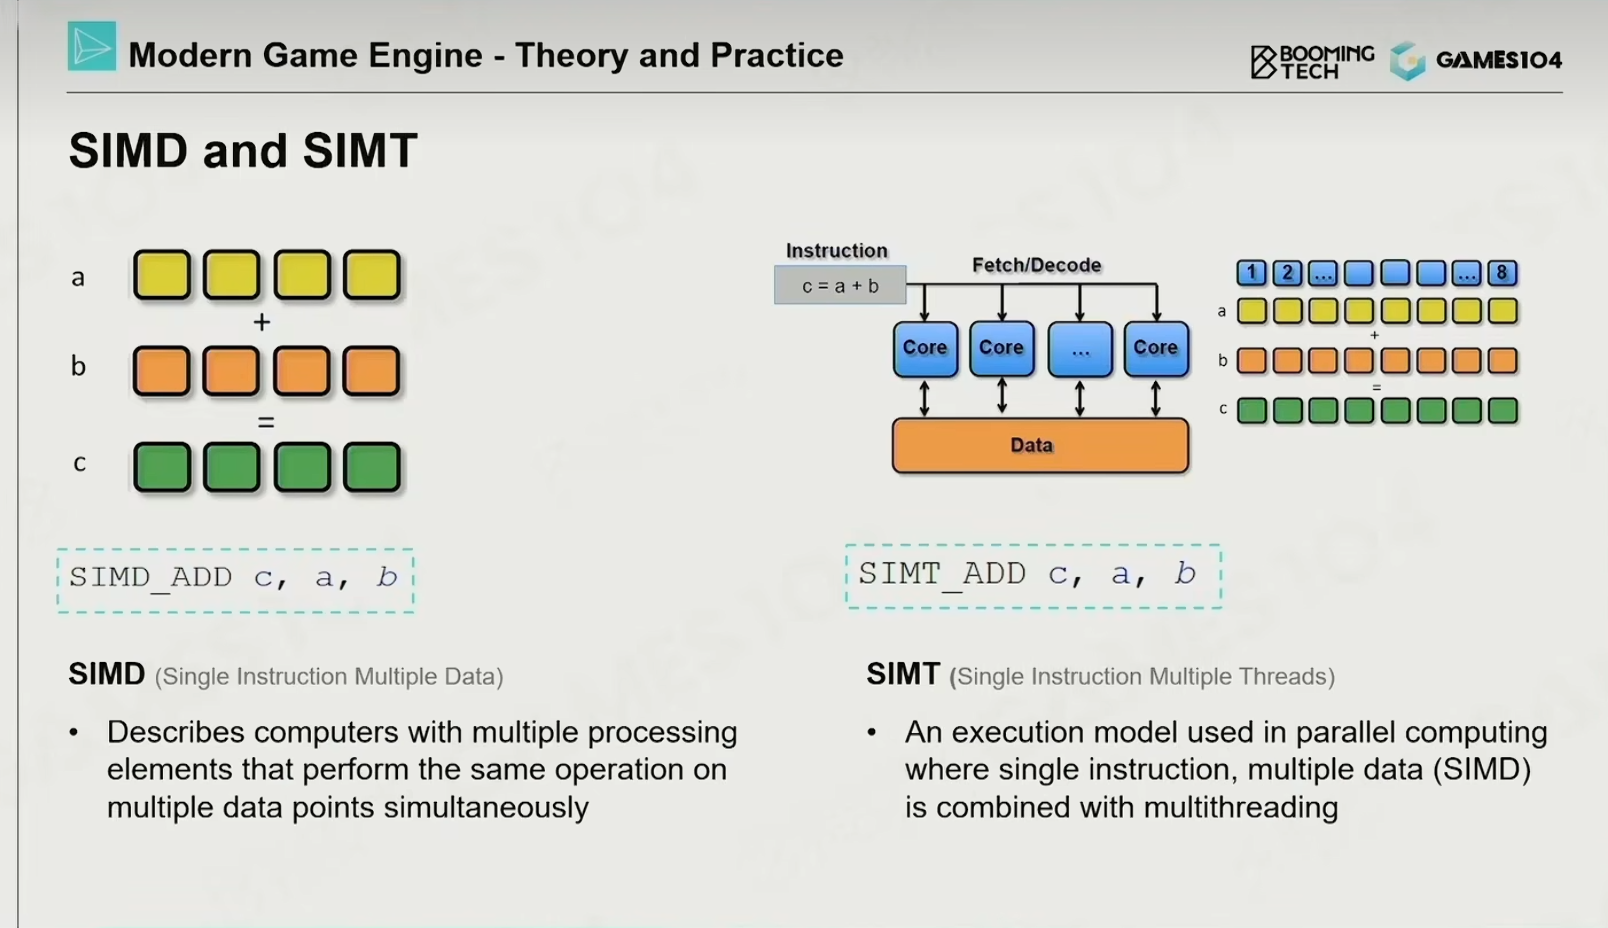
1. SIMD(Single Instruction Multiple Data) 与 SIMT(Single Instruction Multiple Threads)#
- SIMD(单指令多数据流):将多个相同通道的数据打包进入一个超大的寄存器,仅调用一条指令,让一个算术逻辑单元 (ALU)对这些数据执行相同操作
- SIMT(单指令多线程):将大量独立线程组织成逻辑组,并行的对数据进行处理
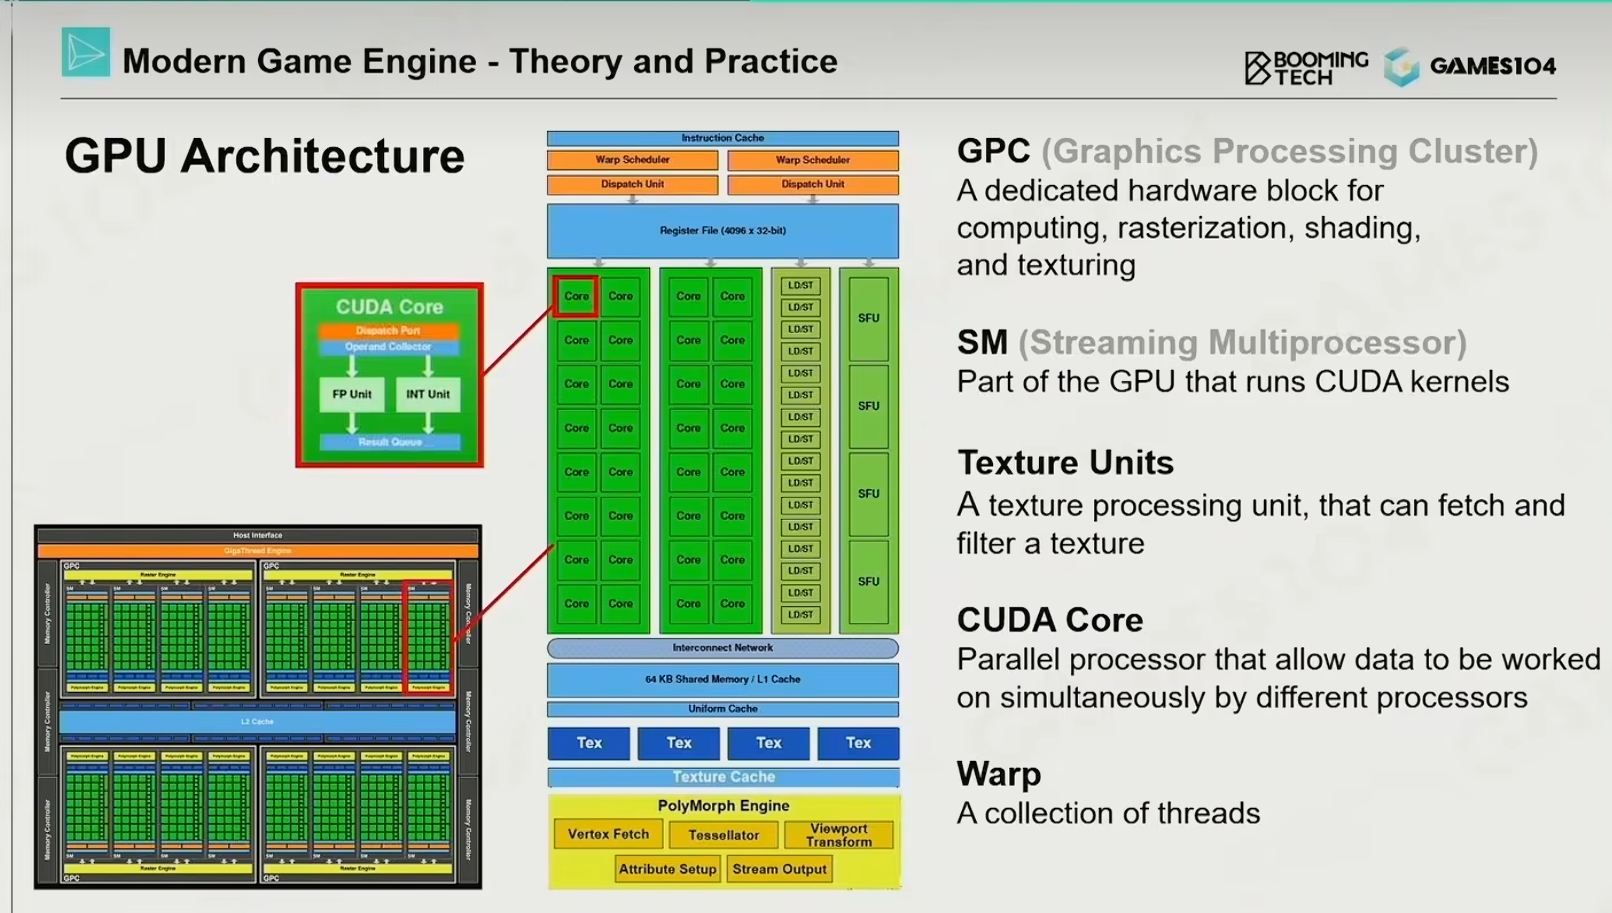
2. GPU 架构#
- GPC(Graphics Processing Cluster)
- SM(Streaming Multiprocessor)
- Texture Units
- CUDA Core
- Warp
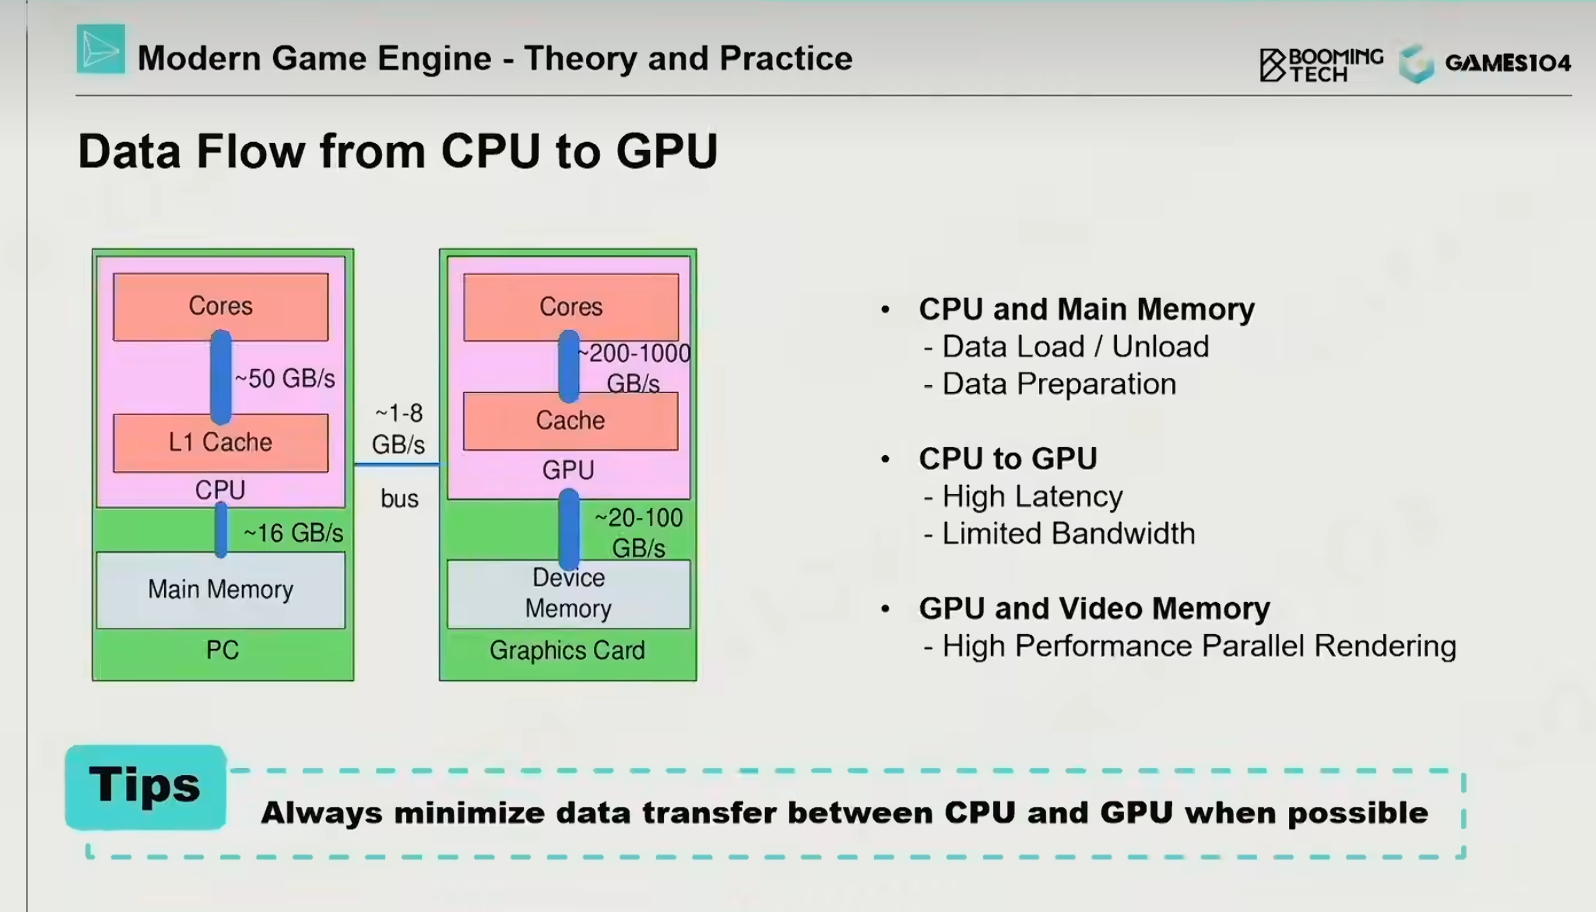
3. CPU 与 GPU 之间的数据流动#
在游戏引擎中有一个原则:尽可能只让数据单向传输,即只让数据从 CPU 传入 GPU,而不从 GPU 中读取数据并传输到 CPU
同时要利用好 Cache 的作用——因为如果 CPU 无法在自己的 Cache 中寻找到所需数据的话,就需要去内存寻找,而这会极大拖慢运行速度
Cache Hit:CPU 在缓存上找到数据 Cache Miss:CPU 无法在缓存上找到数据
三:可渲染物体#
组成:Mesh Primitive、Vertex Buffer 与 Index Buffer、Material、Textures、Shaders
对于一个 mesh,根据材质的不同,会被切分为多个 submesh;一个 buffer 用来存储一整个 mesh,而每一个 submesh 占其中一小段
但是如果对于每一个几何体,都开辟一个 buffer 去存储数据,会造成内存浪费(比如:多个物体共用一张贴图,但是却开辟了多个内存空间为每个物体单独存储一张相同的贴图)
将 Shader、Texture、Mesh 等数据放入一个 Pool 中,确保资源可以复用
四:可见性裁剪#
层次视锥剔除:Quad Tree Culling、BVH……
现代游戏中通常存在着大量可动的物体,因此包围结构不仅要能够进行快速地求交,更要能够执行快速地重建,而 BVH 恰好满足这几点,这也是现代游戏引擎中用的最多的算法
Portal and PVS Data:#
Portal(门)与 PVS(预计算可见性集合)都是经典的室内空间剔除技术,Portal 是在运行时由 CPU 沿着房间之间相连的“门窗”进行递归裁剪,只渲染视野穿过这些孔洞所能看到的区域;而 PVS 则是将世界切成网格,在离线阶段提前烘焙出每个网格点“可能看到”的物体列表,运行时玩家走到哪就直接 $O(1)$ 查表剔除,不耗费运行时算力。两者皆以结构的封闭性换取极致的渲染性能
GPU Culling:#
指的是将原本由 CPU 负责的画面可见性裁剪工作,完全移交给 GPU(通常利用 Compute Shader)来完成的技术。
在传统渲染管线中,CPU 需要逐个计算物体的包围盒是否在视野内,然后再向 GPU 发送渲染指令(Draw Call)。当场景中物体达到数十万级别时,CPU 会因庞大的计算量和频繁的提交产生严重的性能瓶颈。
而 GPU Culling 颠覆了这一流程:CPU 直接把场景中所有物体的数据一次性打包扔给显存,随后 GPU 利用自身恐怖的并行算力,在微秒级别内瞬间完成数十万物体的视锥体和遮挡测试,直接在显存中生成最终需要渲染的物体列表并自主绘制。
五:纹理压缩#
在游戏引擎中,图片不是以诸如 PNG、JPEG 等格式存在的,因为这些压缩方式并不支持随机访问,并且计算的复杂度非常高
实际用到的压缩技术是——Block Compression:
将一张图片分为多个色块(比如 4 x 4),对于每一个色块,只存储其中的像素的最大值与最小值,而其他像素可以认为是这两个像素值插值得到的结果
在 PC 上:有 BC7(modern)、DXTC(old)等
在移动端上:有 ASTC(modern)、ETC / PVRTC(old)等
六:建模工具#
七:新的模型管线#
Cluster-Based Mesh Pipeline#
核心思想是放弃以“单个三角形”或“整个模型(Mesh)”为单位的传统处理方式,改由将模型切分成固定大小的“网格簇(Cluster)”作为基础计算单元,并完全由 GPU 驱动进行并行渲染。
Nanite#
相当于是 Cluster-Based Mesh Pipeline 的更进一步
原文:渲染实践